Formatos de audio espacial: object, channel, scene y binaural
Object-based, channel-based, scene-based y binaural, explicados primero en palabras simples y después en detalle. Qué es cada uno, qué no es y cuándo tiene sentido en un proyecto.
Después del certificado de Dolby Atmos seguí estudiando otros formatos inmersivos por mi cuenta. Había hecho pruebas con Ambisonics, pero nunca lo había podido trabajar en un espacio inmersivo real.
Eso cambió en Notam, el centro noruego de tecnología, arte y música en Oslo. Tuve la oportunidad de hablar con Thomas Johansen, uno de sus ingenieros, sobre las diferencias entre formatos, sus ventajas y sus límites, sobre todo Ambisonics y Dolby Atmos. Ambisonics es su preferencia, por varios motivos. Es abierto y libre de usar. Te permite ampliar la cantidad de altavoces hasta donde el espacio lo permita. Y deja integrar o crear herramientas dedicadas alrededor. Thomas es ingeniero, pero también creativo y artista, y esa apertura importa a alguien que construye herramientas tanto como hace obra con ellas.
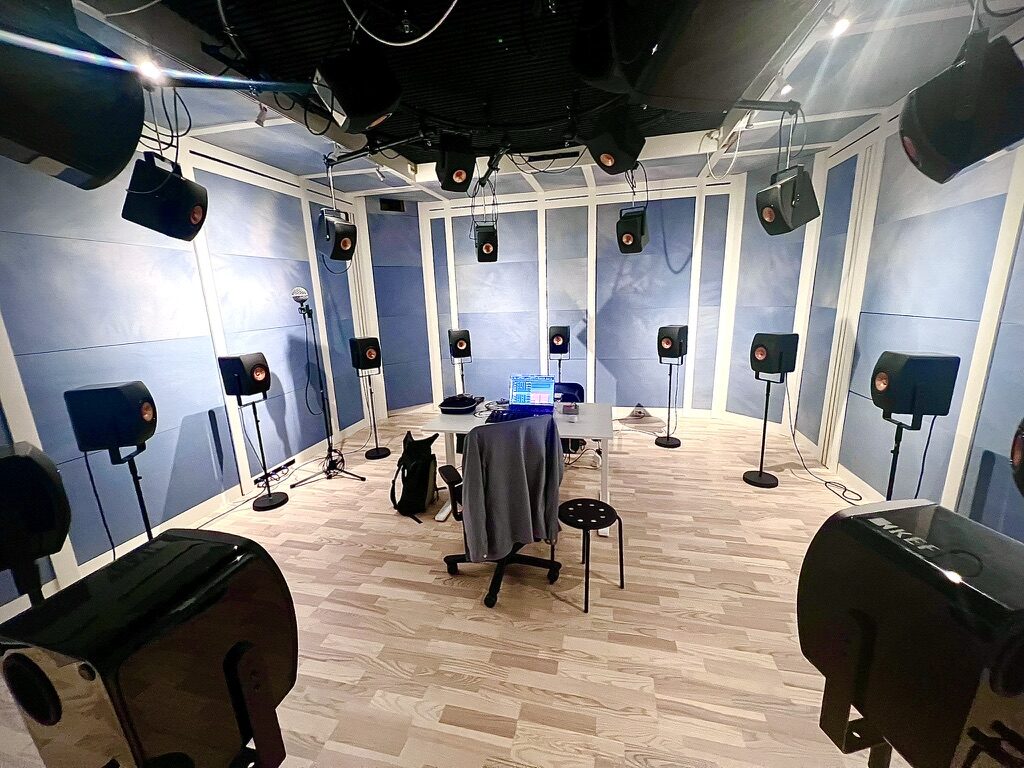
Immersive Studio, Notam, Oslo.
Poco tiempo después le escribí a Martin Abrahamsen, studio manager y head engineer de Rainbow Studio, en Oslo desde 1984. Yo estaba por la zona y me aceptó con muy poco aviso. Mientras hablábamos me mostró el estudio, en lo que estaba trabajando, y las herramientas que construye con IA y cómo las integra en su workflow. Fue generoso con su tiempo, y curioso de la forma que me gusta, un ingeniero que construye sus propias herramientas en vez de esperar a que otro las haga. Entre muchas otras cosas hablamos de su sistema Dolby Atmos, el formato con el que estoy más familiarizado. Él lo usa sobre todo para música, y por ahora no son tantos los artistas que piden mezclas inmersivas como para que ampliar el equipo tenga sentido todavía. Aun así, el sistema que ya tiene es impresionante.
Cada uso tiene un enfoque distinto, y hay quien piensa que un formato es mejor que otro, cada uno por sus motivos. Para mí lo interesante es entenderlos todos y aprender a usar el que un proyecto necesita en cada momento. Por eso decidí escribir este artículo.
Las cuatro palabras se mezclan todo el tiempo, en foros, en manuales de plugins y en conversaciones: channel-based, object-based, scene-based, binaural. No son cuatro versiones de lo mismo. Si eliges la equivocada, nada se rompe de forma evidente. La mezcla simplemente le llega al oyente un poco distinta, y no sabes por qué.
Primero en palabras simples, después el detalle. Si un término es nuevo para ti, enlaza a su entrada en el Glosario de Audio.
La versión corta
- Channel-based (audio basado en canales): cada canal va a un altavoz. El estéreo tiene 2 canales, el 5.1 tiene 6. Los altavoces solo reproducen el canal que reciben. Si la sala tiene más o menos altavoces que canales tiene la mezcla, hay que convertirla.
- Object-based (audio basado en objetos): cada sonido lleva su posición. Ningún altavoz tiene un canal fijo. El sistema de reproducción calcula qué altavoces reproducen cada sonido, y a qué volumen, con los altavoces que haya en la sala. Más altavoces dan una posición más precisa.
- Scene-based (audio basado en escena): graba el sonido que llega desde todas las direcciones a un punto. Aquí tampoco hay un canal por altavoz. Un decodificador combina todos los canales en una señal para cada altavoz, según dónde esté ese altavoz. Funciona mejor con los altavoces repartidos de forma pareja alrededor del oyente.
- Binaural: 2 canales para audífonos que hacen que los sonidos parezcan venir de tu alrededor. No funciona en altavoces: cada oído escucha los dos altavoces y se pierde casi todo el efecto.
Los tres primeros son formas de construir y guardar una mezcla. Binaural es una forma de entregarla. Esa sola diferencia aclara casi toda la confusión.
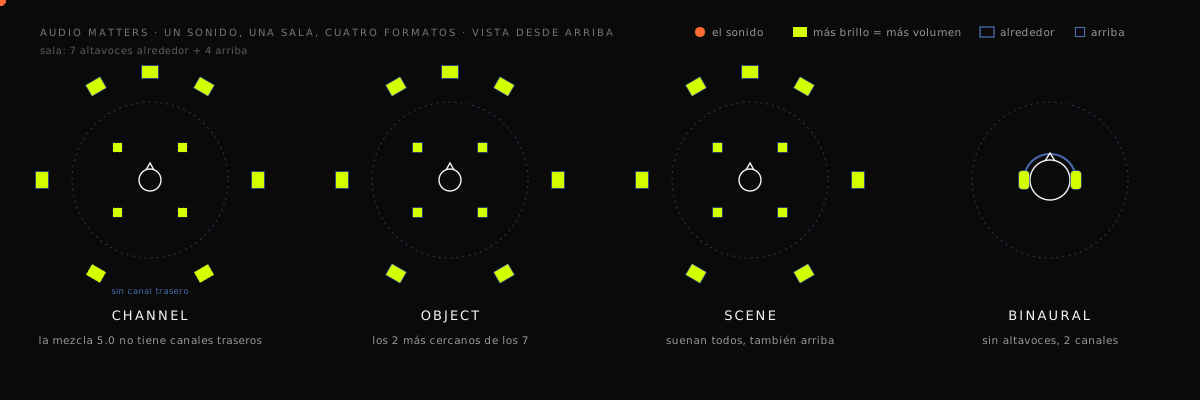
Channel-based audio
En palabras simples: cada canal va a un altavoz en un lugar conocido. El estéreo es el ejemplo que todos conocemos: el canal izquierdo va al altavoz izquierdo y el derecho al derecho.
El channel-based audio es el formato de siempre. El estéreo, el 5.1, el 7.1 y las distribuciones más grandes de cine y broadcast funcionan así. La mezcla queda terminada en el momento en que la exportas, y la posición de los altavoces se da por hecha, no se calcula.
Esa es su fortaleza y su límite. La reproducción es simple y funciona en todas partes. Pero si la sala tiene otra distribución, la mezcla hay que reducirla o expandirla (un downmix o un upmix), y en el camino siempre cambia algo. Una mezcla surround 5.1 no se convierte en una mezcla 7.1.4 de verdad sin volver a la sesión.
Lo encuentras en stems WAV multicanal, Dolby Digital, DTS, masters de broadcast y en cada master estéreo que hayas entregado.
Object-based audio
En palabras simples: en vez de decidir qué altavoz reproduce cada sonido, describes dónde está el sonido, y el sistema de reproducción resuelve el resto.
El object-based audio separa dos cosas que el channel-based mantiene juntas: el sonido en sí y la información de su posición. Un objeto es un sonido más su metadata (dónde está, cómo se mueve, a qué volumen). Un renderer lee esa metadata al reproducir y asigna el objeto a los altavoces que existan en esa sala, o a los audífonos.
Dolby Atmos es el ejemplo con el que más trabajamos. Un master de música suele combinar un bed, que es channel-based y llega hasta 7.1.2, con objetos que se mueven libremente, hasta 128 entradas en total. El bed se queda en 7.1.2 aunque la sala sea 7.1.4 o 9.1.6. A los altavoces de altura extra llegan los objetos. Ese master viaja como un archivo ADM BWF. Tiene extensión .wav, pero por dentro lleva la metadata que necesita el renderer. MPEG-H es el equivalente que se usa en broadcast.
La gran ventaja: un solo master sirve para una barra de sonido, un estudio 7.1.4, un cine o unos AirPods, cada uno con la calidad que permita el equipo. El costo: necesitas un renderer al reproducir, los archivos pesan más, y si la metadata está rota el audio está bien pero una plataforma estricta puede negarse a decodificarlo.
Lo encuentras en los lanzamientos Atmos de Apple Music, Tidal y Amazon Music, en las entregas para Netflix y en el cine actual.
Scene-based audio
En palabras simples: grabas o construyes el sonido que llega desde todas las direcciones a un punto de escucha. Después, un decodificador lo convierte a los altavoces o audífonos que tengas.
El scene-based audio es la familia de Ambisonics. No describe altavoces ni objetos. Describe el sonido que llega a un punto, repartido en canales donde cada uno capta el sonido de un conjunto distinto de direcciones.
Ambisonics de primer orden usa cuatro canales. Uno funciona como un micrófono omnidireccional y los otros tres captan adelante-atrás, izquierda-derecha y arriba-abajo. Los órdenes más altos suman canales y precisión: el tercer orden usa 16 y el séptimo 64. La convención habitual hoy se llama AmbiX, y es la que espera YouTube 360.
Como la escena es un campo alrededor del oyente, girarla es fácil. Por eso combina tan bien con el head tracking y por eso es el formato estándar para VR y video 360. El límite es la precisión. En primer orden, la posición de los sonidos se siente un poco difusa. Los órdenes más altos lo corrigen a cambio de muchos más canales.
Lo encuentras en videos de YouTube 360, experiencias de VR y grabaciones hechas con micrófonos de campo sonoro como el Sennheiser Ambeo o el Rode NT-SF1.
Binaural
En palabras simples: dos canales, hechos para audífonos, procesados como tu cabeza y tus oídos procesarían un sonido real que llega desde una dirección concreta.
El binaural es un formato de entrega para audífonos, no una forma de construir una mezcla. Funciona con la HRTF (Head-Related Transfer Function), una medición de cómo tu cabeza, tus hombros y tus orejas filtran el sonido según de dónde viene. Aplica ese filtrado a un sonido y tu cerebro lo ubica fuera de tu cabeza.
Un archivo binaural puede venir de tres lugares. Se puede grabar con una cabeza artificial (dummy head), un micrófono con forma de cabeza humana como el Neumann KU 100. Se puede renderizar desde una mezcla object-based, que es lo que pasa cuando escuchas una canción en Atmos con audífonos. O se puede decodificar desde una grabación scene-based.
En mi artículo sobre mezclar Atmos con audífonos escribí que ahora estoy convencido de que puedo hacer casi toda la mezcla con audífonos. El render binaural es lo que lo hace posible. También tiene un límite que conviene conocer: la HRTF del renderer es un promedio, no tu cabeza, así que lo que para una persona suena perfectamente ubicado, para otra puede sonar un poco dentro de la cabeza. El head tracking, como el Spatial Audio de Apple en los AirPods, ayuda mucho porque mantiene el sonido fijo en la sala cuando giras la cabeza.
Lo encuentras cada vez que alguien escucha un lanzamiento Atmos con audífonos, en los visores de VR y en los videos 360 que se ven sin visor.
Cuatro confusiones que me encuentro una y otra vez
"Dolby Atmos es un formato de archivo." Atmos es un ecosistema: una forma de mezclar con objetos, un renderer y un conjunto de reglas de entrega. El archivo en el que viajan casi todos los masters Atmos es ADM BWF. Y cuando una canción Atmos suena en tu teléfono con audífonos, lo que escuchas es un render binaural.
"Ambisonics y audio 360 son lo mismo." Ambisonics es la técnica. El audio 360 es uno de los lugares donde se usa. YouTube los hizo parecer sinónimos porque sus videos 360 usan Ambisonics de primer orden.
"Spatial Audio significa Dolby Atmos." Spatial Audio es el nombre que Apple le da a una experiencia. Puede ser una canción Atmos renderizada a binaural, con o sin head tracking, o incluso una canción estéreo normal repartida a tu alrededor. Mismo nombre, cosas distintas por debajo.
"El binaural es un archivo 3D." Un WAV binaural es un WAV estéreo. La sensación de espacio viene de cómo se procesaron los dos canales, no de canales extra. Si lo reproduces en altavoces, casi todo el efecto desaparece.
Cuál usar y cuándo
- Música para streaming: el estéreo channel-based sigue siendo la base. Atmos (object-based) es un lanzamiento paralelo, no un reemplazo.
- Cine y series: Atmos object-based para la entrega premium, normalmente acompañado de una versión channel-based 5.1 o 7.1.
- VR, video 360 e instalaciones donde el oyente se mueve: scene-based, porque el punto de escucha cambia y el decodificador tiene que seguirlo.
- Todo lo que se escucha con audífonos: binaural, renderizado desde cualquiera de los otros tres.
La plataforma decide el formato de entrega. Lo que el proyecto va a ser decide el formato de trabajo. Si todavía no puedes responder "¿qué va a reproducir esto?", es demasiado pronto para elegir.
Si eres ingeniero, o artista
Para ingenieros, aquí no hay ningún secreto, pero puede ayudarte a explicarle a un cliente por qué su "mezcla Atmos" también necesita un master estéreo, o por qué el render binaural en sus AirPods no suena como tu estudio.
Para artistas y productores, no necesitas dominar las matemáticas. Saber cuál de las cuatro preguntas plantea tu proyecto basta para tener una conversación mucho mejor con quien lo mezcle.
Para seguir
- LUFS Explorer, para ver cómo funciona la normalización de loudness en cada plataforma, Atmos incluido.
- [A³] Delivery Analyzer, que revisa entregas estéreo y surround y la estructura de los archivos ADM BWF antes de enviarlos.
- Dolby Atmos QC Pack, una guía de entrega, un wall chart y una checklist para proyectos Atmos.
- Glosario de Audio, todos los términos de este artículo y muchos más.
Para profundizar, si quieres más detalle: Franz Zotter y Matthias Frank, Ambisonics (Springer, 2019). Michael Gerzon, "Periphony: With-Height Sound Reproduction" (Journal of the AES, 1973). ITU-R BS.2051 para las distribuciones de altavoces y BS.2076 para el Audio Definition Model.
Si algo aquí está mal o no se entiende, dímelo. Prefiero corregirlo que dejarlo así.
- Andrés 🫀